
 联盟


选一个 AI 助手帮忙跑自动化任务时,名单上常见的是 Claude、GPT 和几家国产旗舰。11 月 2 日,美团正式发布了 LongCat-2.5,一个专攻长程智能体任务的原生多模态模型,官方基准成绩显示它在多个 Agent 评测上与两家旗舰打成了互有胜负——这份成绩单值得每个在选型的人认真看一眼。
规模与架构:激活 480 亿的 1.6 万亿 MoE
LongCat-2.5 的总参数量达到 1.6 万亿,采用 MoE 架构,每个 token 激活约 480 亿参数。相比上一代 LongCat-2.0,这代重点强化了两条线:原生视觉理解与智能体编程。
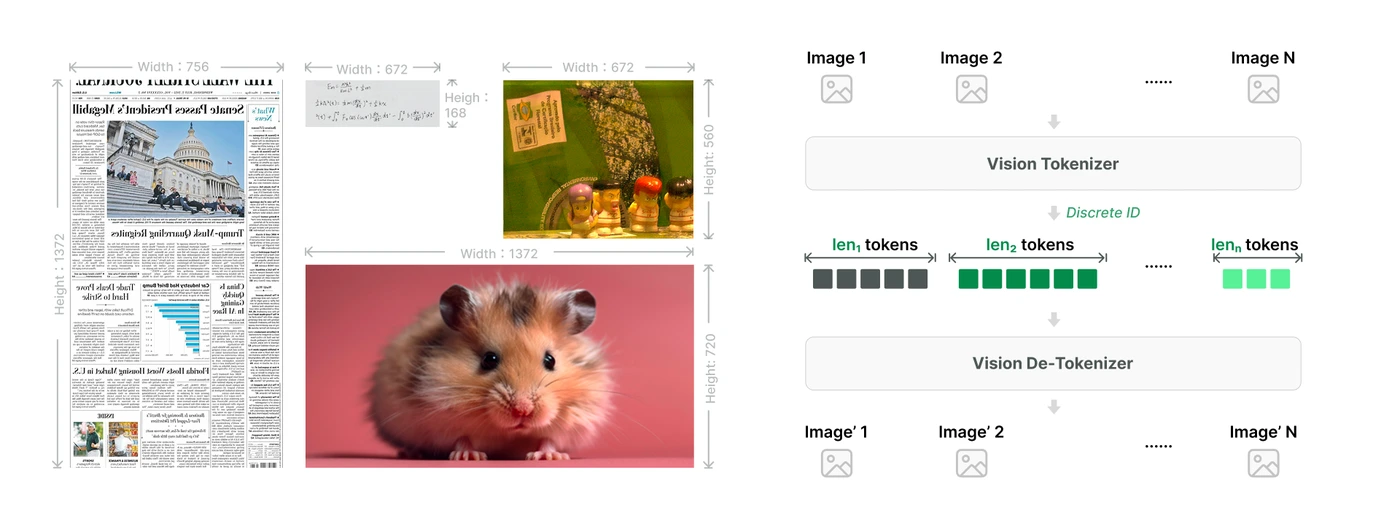
视觉部分没有走"外挂视觉编码器"的老路,而是把视觉信号表示为多层级离散 token,让主干模型用统一的 token 形式处理图像和文本。官方称其在 Visual Coding(看图写代码、改界面)上表现出色,还支持创意设计和 3D 建模类任务。
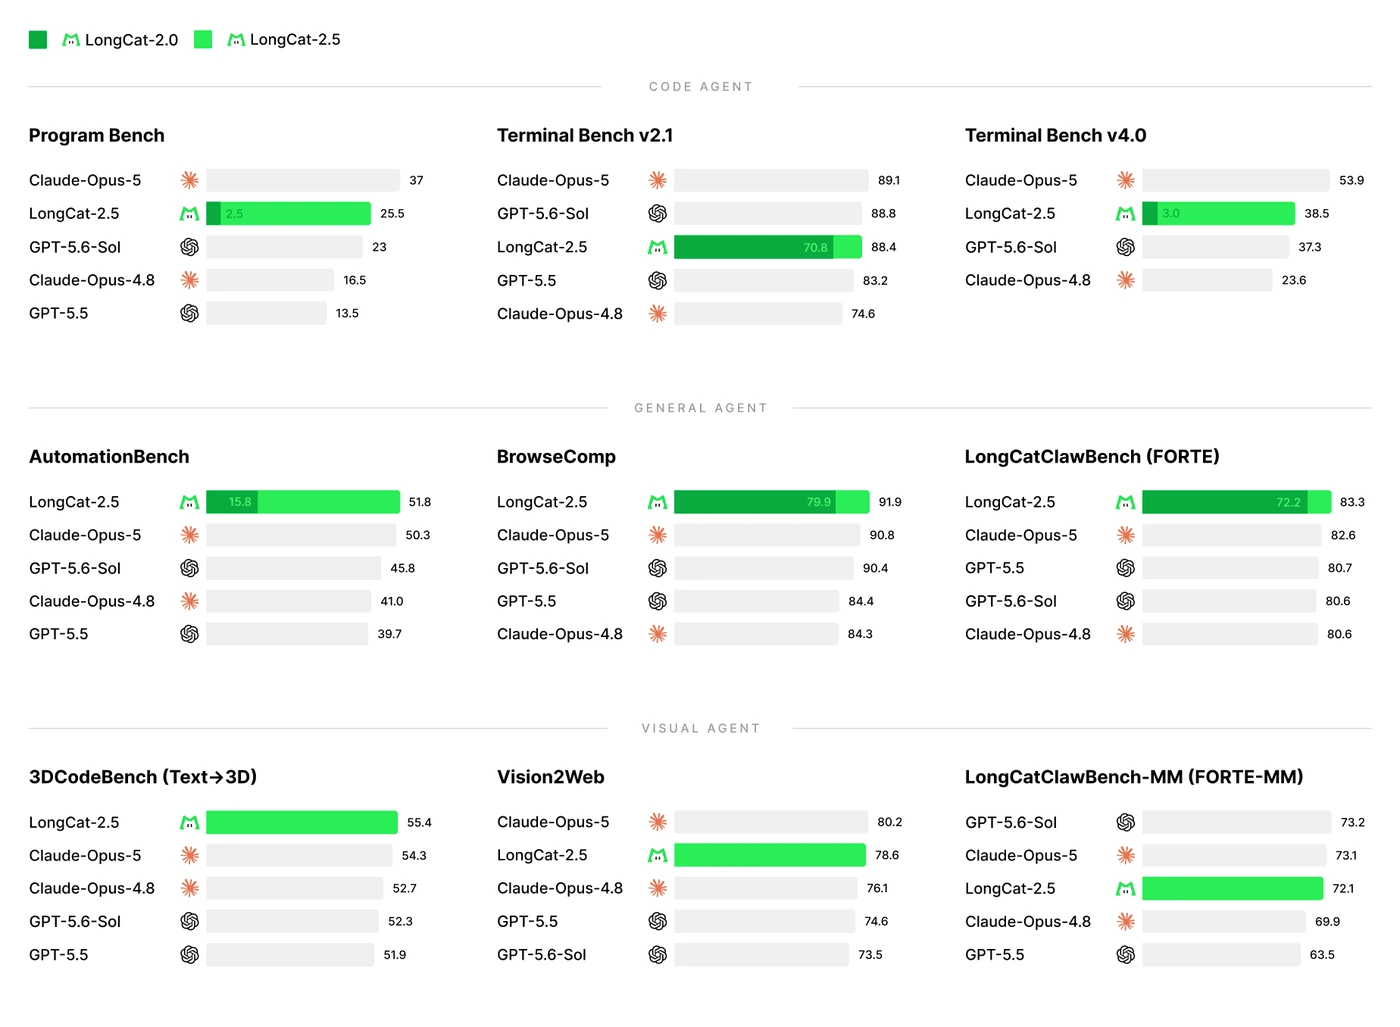
跑分:三项第一,两项咬得极紧
把官方公布的九组数据里最值得关注的几项拆出来看:
- AutomationBench(自动化任务):LongCat-2.5 拿下 51.8,压过 Claude-Opus-5 的 50.3,是榜单第一。
- BrowseComp(网页浏览任务):91.9 对 Claude-Opus-5 的 90.8,第一,但差距只有 1.1 分。
- 3DCodeBench(文本转 3D):55.4 同样排第一,领先 Claude-Opus-5 的 54.3。
- Terminal Bench v2.1(终端操作):88.4,与第一梯队的 89.1、88.8 几乎持平。
- Program Bench:25.5,落后于 Claude-Opus-5 的 37,这是官方自己也没有回避的短板。
一句话概括:长程自动化与网页操作是它的强项,纯代码生成与最强的 Claude 旗舰还有一段距离。对使用者来说,这个组合反而很实用——如果你的场景是"让模型连续跑一串网页操作、表单填写、系统维护",LongCat-2.5 的性价比会很有吸引力。
训练侧的两个看点
技术博客里有两处细节对从业者有参考价值。其一是大规模智能体强化学习:美团把 GitHub 公开仓库的真实 PR 与 issue 转化成可验证的训练环境,用 fail-to-pass 测试校验任务有效性,并采用 partial rollout 异步策略处理长轨迹训练的效率问题,还专门针对"刷分式投机"做了断网训练、清除 git 历史等防 reward hacking 处理。
其二是国产算力适配:整套训练跑在单卡显存不足 80GB 的国产加速器上,通过超节点并行与双重分片 FSDP,长序列微调的单卡吞吐比基线提升 86%;推理侧的 W4A4 量化方案让线上压测吞吐相对 W8A8 提升 43.3%。这两组数字意味着模型后续开源时的部署门槛不会高得离谱。
还有一个容易被忽略的机制叫"多专家在线教学":模型按智能体、推理、交互体验等方向各养了一个领域专家,学生在真实任务里采样,教师对采样结果做全词表级别的纠正,训练效率比离线蒸馏高出一截。这套机制在 LongCat-2.0 上验证过,这代继续沿用并优化了长回复场景下的分布偏移问题。对普通用户来说不用深究原理,只需要知道:这类设计的直接收益,是模型在多轮任务里更少"跑偏重启"。
现在怎么用上它
- 在线体验:打开 longcat.chat ,注册后即可对话,网页版支持图片输入,可以直接扔一张界面截图让它写前端。
- API 接入:开发者走 longcat.chat/platform/product 申请,按官方页面的接入文档调用。
- 关注开源动态:官方说明模型权重在 GitHub 与 Hugging Face 即将上线,自己动手部署的话留意仓库更新。
体验时可以重点试三类任务:给一张产品截图让它还原成 HTML;粘贴一段长文档让它多步检索并汇总;用一段自然语言描述让它规划并执行一串模拟操作。这三类正好对应它训练时重点打磨的能力。
测试时建议顺手记录三个指标:多轮任务里中断重来几次、网页操作的成功率、以及同样任务对比你现在的主力模型耗时多少。跑分表上的 0.5 分差距落到具体任务里可能就是"能用"与"不能用"的区别,自己的一手数据永远比榜单可靠。
值得关注的理由
国产大模型这几年的竞争焦点,已经从"聊天谁更聪明"转到"谁的智能体能把活干完"。美团这次没有讲太多通用对话的故事,而是把资源压在长程任务、环境构建和算力效率这些硬骨头上,赛道选择很清晰。1.6 万亿总参、480 亿激活的配置,加上网页上就能免费试用的开放态度,让它成为这个月最值得排进测试清单的国产模型。跑分是别人家的,任务是你的:拿自己手头最烦的那件自动化小事去考一考它,答案自然见分晓。
文章标题:美团LongCat-2.5上线:1.6万亿参数主打智能体,网页上就能试
文章链接:https://www.muooy.cn/16374.html
更新时间:2026年11月04日
1.本站大部分内容均收集于网络!若内容若侵犯到您的权益,请发送邮件至:305582964@qq.com,我们将第一时间处理!2.资源所需价格并非资源售卖价格,是收集、整理、编辑详情以及本站运营的适当补贴,并且本站不提供任何免费技术支持。
3.所有资源仅限于参考和学习,版权归原作者所有,更多请阅读用户协议和免责声明。
- 1B2 主题圈子发图片不显示?不用插件,改两处就能修好10月13日
- 2索尼克赛车交叉世界第二赛季试玩:EVA和哥斯拉把赛道变成名场面10月11日
- 3开源iPhone-use实测:让Codex通过USB操控真实iPhone10月11日
- 4赛博朋克2077真人电影官宣:派拉蒙联手CDPR打造夜之城10月10日
- 5GitHub热门开源ARTEX实测:AI自主渗透测试系统的Docker部署全流程10月10日
- 6逃离塔科夫1.2版本上线:PvE转生系统与老带新计划同步到来10月7日
- 7天马行空WP智能体-免费开源的AI智能体插件、一句话管理全站8月26日
- 8WordPress网盘链接自动转二维码分享插件8月16日
- 9Gramps v6.0.6 开源免费族谱管理软件11月10日
- 10WordPress 中获取所有分类 ID 的实用函数:get_all_category_ids 详解7月12日